

Akademik Yayıncılıkta Yapay Zeka Uzmanı
caggursoy93@gmail.com
Giriş
The auguries are raining down hard. Think or Sink. Comply or Die. Look Up or be Left Out. And so, with these not-so-gentle threats, it has come to pass that the Age of AI – Actual Idiocy, Actual Super Idiocy, Recursive Snowballing-Idiocy – is upon us.
Arundhati Roy [1]
Arundhati Roy 15.10.2026’da Equator dergisinde yayınlanan son makalesi Apocalypse Now and Then’e böyle başlıyor. Makale boyunca Roy 2020 itibariyle adeta bir Manhattan projesine dönüşen yapay zekâ teknolojilerinin – daha açık olmak gerekirse istifçi veri şirketlerinin – karşısında bireylerin durabileceği noktaları ortaya koyuyor. Bunun yanı sıra Roy, önermelerini özeleştirel bir şekilde yorumlayarak, şu an içinde bulunduğumuz bu sıkıntılı teknolojik sıçrama dönemi Batı Avrupa’da 18 ve 19. yüzyıllarda yaşanan Sanayii Devrimi’ne benzetiyor. Bu benzetmeyi yaparken de skeptik bir yaklaşımla kendisinin ahlaki panik durumuna düşüp düşmediğini değerlendirmek istiyor. Yazısını bitirirken ise aldığı pozisyonu net olarak anlıyoruz, “But what I really want to say about those AI companies is this: terminate with extreme prejudice.”
Her ne kadar Roy ve bir takım yazarlar bir araya gelerek Anthropic’e bir toplu dava açmış olsalar da – ve aslında kamuya görünen yüzünde bu dava Anthropic aleyhine sonuçlanmış olsa da – bu davanın sonucu sadece şirketin bir maddi uzlaşma yoluyla sıyrılmasına olanak sağlamıştır. Roy ve diğer yazarların yıllarca okuyarak, tartışarak, görerek – yani insani zekâ ve yeteneklerini kullanarak – ürettikleri basılı eserleri Anthropic yasal olmayan yollarla (dava tutanaklarında Library Genesis ve Pirate Library Mirror isimli websitelerinden elde edildiği kayda geçirilmişti) etmesi kesinlikle cezalandırılmamış; ayrıca yazarların fikri mülkiyeti Anthropic’in YZ modelleri için bir taban oluşturmuştur. (Bu dava ile daha detaylı bilgi için: https://www.anthropiccopyrightsettlement.com/faq)
20.yüzyılda, özellikle İkinci Dünya Savaşı’nın ardından, Batı Avrupa ülkeleri ve Amerika Birleşik Devletleri artık kendileri için Endüstri Çağı’nın yavaş yavaş sona erdiğinin farkına varmış; ve bir sonraki çağın temellerini atmaya başlamıştı: Bilgi (veya Bilişim) Çağı. 1997-2000 arasında ortaya çıkıp, 2001’deki büyük küresel ekonomik krizin sebeplerinden biri olarak görülen dot-com balonunun üzerinden daha 30 yıl dahi geçmedi. Ancak bu süre zarfında insanların, ve dolayısıyla dijital verinin ve insan emeğinin birbiriyle olan bağlantılılığı üstel bir şekilde arttı. Dünyayı birbirine bağlayan bu dijital ağ sistemi, 1990larda tahmin edildiği üzere, öncelikle 2000 ve 2010ların ilk yarısında insan bilgisinin ve deneyiminin özgürce paylaşıldığı bir alan olarak hayatımızda bir yer aldı. 2010ların sonlarına doğru, özellikle sosyal medya platformlarının önlenemez yükselişi ve insanların dijital varlıklarının davranışsal olarak takip edilebilirliği açıkça ortaya konulduktan sonra bu özgür ortam ekstrem merkeziyetçi ve platformdan platforma insanların arkasında verilerinden – adeta Hansel ve Gretel gibi – ekmek kırıntıları (veya internet jargonunda cookie) bir yol bırakarak zıpladığı bir sistem hâlini aldı. İçinde bulunduğumuz 2020lerde ise bu dijital ekmek kırıntıları, internetteki insan emeği ve çıktılarıyla birleşerek üretken YZ algoritmaları için bir temel oluşturdu. Peki, verilerimizi ellerinde tutan; kullanıcıların boğazlarından içeriye bitmek bilmeyen bir açgözlülükle abonelik ücretleri dayayan bu mega-şirket kapitalistlerine dijital kamunun savaşacak bir silahı yok mu? İşte bu yazıda bu savı oluşturacağım. Bunun için de iki koldan ilerleyeceğim: önce bitmek bilmeyen dijital veri istiflemesinin en uç örneklerinden biri olan Anthropic’in kitap (yoketme) operasyonuna değineceğim, sonra buna karşı kurulabilecek toplu bir hat önereceğim: açık kaynak, açık veri ve kamusal dijital altyapı.
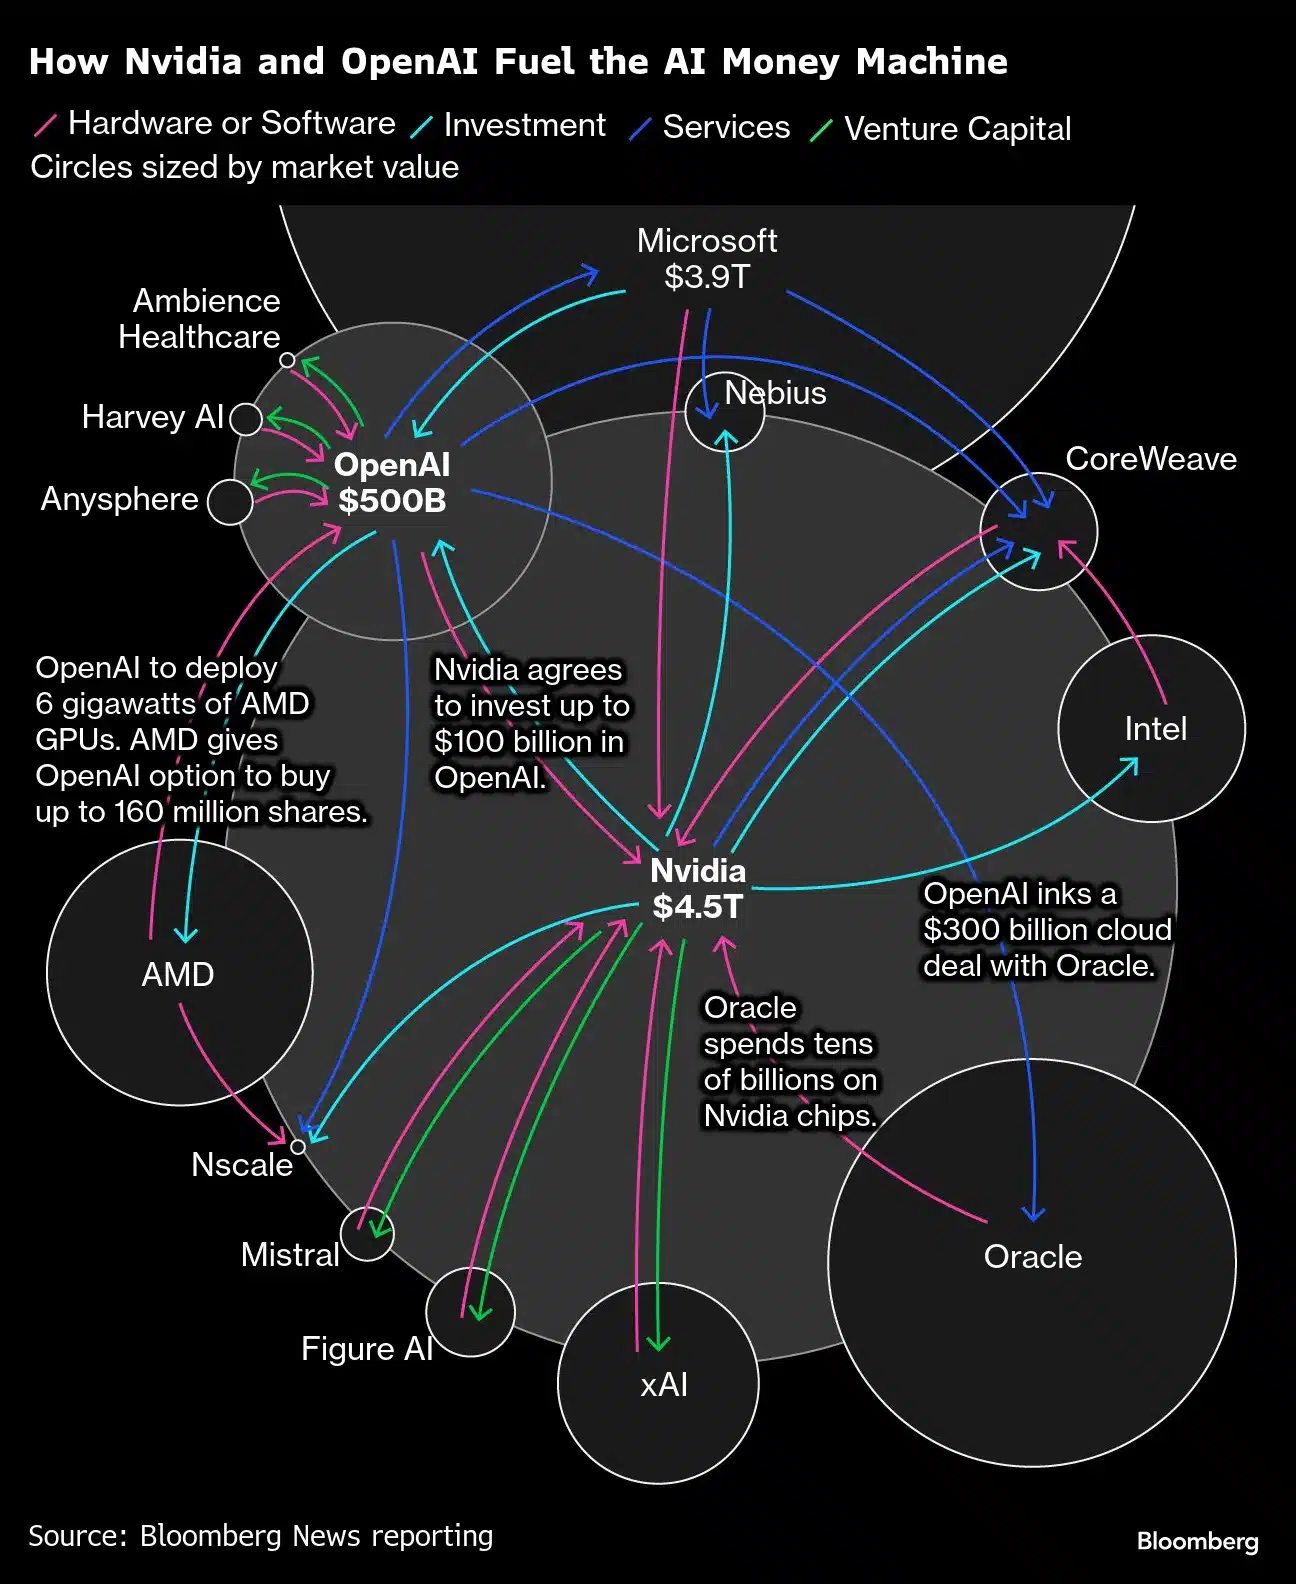
Nvidia ve etrafındaki diğer şirketlerin YZ üzerine kurduğu ‘döngüsel yatırım’ sisteminin şeması. Kaynak Bloomberg – https://www.bloomberg.com/news/features/2025-10-07/openai-s-nvidia-amd-deals-boost-1-trillion-ai-boom-with-circular-deals
- Kitap istifçiliği: Anthropic ve veri duvarı
Klasik yapay zeka (YZ) modellerinin bir alt kümesi olan ve 2020lerde yükselişe geçen büyük dil modelleri (BDM), en basit tasvirle bir sözcüğü olasılıksal olarak bir sonraki sözcüğe bağlayarak çalışır. Bahsedilen bu olasılıkları da “mükemmelleştirmenin” en kaba (ve en sık kullanılan yolu) modelin eğitimi sırasında insan emeğiyle üretilmiş milyonlarca satırı modele tanıtmaktan geçer. Bir yandan da bu metod devasa YZ şirketlerinin ticari ürünlerinde “model çökmesi” – bu bağlamda YZ’nin ürettiği metinlerin internetten indirilerek tekrar model eğitimi sırasında servis edilmesi, böylece modellerin doğruluğu şüpheli olan sonsuz bir döngüde sıkışması – riskinden kaçınmanın bir yolu oldu.
Bu risk de bütün şirketleri ve üreticileri aynı noktaya itiyor: NVIDIA’nın Anna’s Archive’den 500 TB veri pazarlığı iddiası bunun kanıtı niteliiğinde [2].
2025’te Anthropic’in YZ modellerini bu metodla eğitmek için yasal olmayan yollarla kitapları ele geçirdiği ortaya çıkmıştı. Şirket korsan gölge kütüphanelerden (LibGen, PiLiMi) yaklaşık 7 milyon dijital kitap indirmişti; 1,5 milyar dolarlık anlaşma ABD tarihinin en büyük telif ödemesi oldu [3]. Raporlara göre her bir yazar bu mülkiyet anlaşmasından yaklaşık 3000$ pay aldı. Yine aynı davada mülkiyet haklarını zedeleyen ve kültürel mirasın tamamının tek bir şirketin özel modeline gömülmesinin yolunu açan, Anthropic’in yokedici istifçiliğine destek olacak bir karar daha alındı: basılı kitapların yokedilerek dijitalleştirilmesi “adil kullanım” kapsamında değerlendirildi [4]. Böylece Anthropic’in “Project Panama” – Anthropic milyonlarca fiziksel kitabı toptan satın alıp “kitap giyotini”yle keserek endüstriyel tarama cihazlarından geçirdi, ardından asıllarını imha etti; iç notlar projeyi “dünyadaki bütün kitapların yıkıcı taranması” olarak tanımlıyor [4], [5] – adımı teknolojik olarak bu şirketi ileriye götürüyor olsa da; insan emeğiyle üretilen, bir kısmının son kopyası olduğu iddia edilen bu kültürel miras yok oluşla karşı karşıya kalıyor. Madalyonun bir diğer yüzünde ise Roko’nun basilisk’i var. 2010 yılındada LessWrong forumunda ortaya atılan düşünce deneyi, gelecekteki her şeye kadir bir yapay zekânın, varlığından haberdar olan ama kurulmasına katkı sunmayan herkesi geriye dönük olarak cezalandıracağını öne sürer; “acausal extortion – Nedensellik Dışı Şantaj” – bu argüman kısa tanımla, şantajcı ile kurban arasında doğrudan hiçbir neden-sonuç (nedensel) bağ olmamasını karşılıklı alınan kararların simülasyonlar veya matematiksel öngörüler aracılığıyla tahmin etmesi üzerine kuruludur – ve “Pascal’ın Kumarı” – bu argüman ise kanıt olmasa bile Tanrı’ya inanmanın, sonunda cennet olduğu için daha akılcı olduğunu savunur – ile akrabalık kurar [6], [7]. Basiliski burada istifçiliğin uç-felsefi yansıması olarak okuyorum: Anthropic her taradığı kitapla — rıza almadan — herkesi geçmişe dönük bir şekilde kendi modeline kaydediyor; model “bilen ama katkı vermeyen” kimseyi bağışlamıyor. “Dünyadaki bütün kitapların yıkıcı taranması” hedefi, ezeli bir kehanet motorunun lojistiği. Fark elbette şu: basilisk acausal tehditle itaat talep eder; burada boyun eğme, kitapların yazarlarından rıza almaksızın fikri emeğin gaspıyla gerçekleşiyor. Yani basilisk’in kurgusal şantajı, Anthropic’in fiili istifçiliğinde gerçeğe dönüşüyor.
- İkinci çitleme: zihnin müşterekleri
Buraya kadar anlattıklarımı kuramsal bir zemine oturtmak istersek, karşımıza James Boyle’un “ikinci çitleme hareketi” (second enclosure movement) kavramı çıkıyor. Boyle, 2003 tarihli makalesinde, İngiltere’de köylülerin ortaklaşa kullandığı toprakların çitle kapatılarak özel mülkiyete devredilmesini hatırlatır; ancak bu kez çitlenen şey toprak değil, zihnin gayrimaddi müşterekleridir. Telif haklarının sürekli genişletilmesi, veri üzerinde kurulan tekeller ve fikri mülkiyetin her alana doğru yayılmasıyla birlikte, bir zamanlar herkesin erişimine açık olan bilgi parça parça şirketlerin özel mülkü hâline getiriliyor. Boyle’un asıl uyarısı ise şu: bu çitlemeye karşı koyabilmek için önce “kamu alanı”nı (public domain) siyasi bir kategori olarak yeniden icat etmemiz gerekiyor; aksi takdirde her bir veri tekelini ayrı ayrı, birbirinden kopuk birer skandal olarak konuşup asıl yapısal sorunu gözden kaçıracağız [8].
Peki bu çitleme neden tam da şimdi, bu kadar acımasız bir biçimde sürüyor? Shoshana Zuboff’un “gözetim kapitalizmi” tezi bu soruya güçlü bir yanıt sunuyor: kapitalizmin yeni aşaması, insan deneyimini bedava hammadde olarak talep ediyor; bu deneyimi işleyip “davranışsal artık”a dönüştürerek gelecekteki davranışlarımızı öngören tahmin ürünleri hâline getiriyor. Google ve Facebook ile başlayan bu mantık, artık çok daha derin bir kazıya girişmiş durumda — ve Anthropic’in kitap yığınları da aynı mantığın kültürel miras versiyonundan başka bir şey değil. Zuboff’un anlattığı dünyada dijital benliğimiz ürünleştirilirken, bu dünyadaki karşılığında deneyim, emek ve bellek hammaddeleştiriliyor; yazarların yıllarca okuyarak, tartışarak, görerek biriktirdikleri her şey, bir modelin girdisine dönüşmek üzere sessizce yutuluyor [9].
Bu karamsar tablonun karşısına ise “müşterekler” (commons) literatürü dikiliyor: bilgi, tüketmekle tükenmeyen ve üstelik yönetilebilir bir ortak kaynaktır. Yochai Benkler’in ağ üretimi (networked production) analizi, insanların piyasa mantığına ve şirket hiyerarşilerine başvurmaksızın, gönüllü işbirliğiyle nasıl değer üretebildiğini gösterir; internetin erken dönemindeki özgür paylaşım kültürü bunun en somut kanıtıdır [10]. Elinor Ostrom ve Charlotte Hess ise bilgiyi bir müşterek olarak ele alıp bunun yönetişim sorununa dikkat çeker: ortak kaynaklar, ne devlet ne de piyasa eline geçmeden, onu kullanan toplulukların kendi kurallarıyla sürdürülebilir biçimde yönetilebilir [11]. İşte açık kaynağın ve açık verinin savunusu tam da bu geleneğe dayanır — istifçi şirketlerin çitlemeye çalıştığı şey, aslında hepimizin ortak malıdır ve ortak malı yönetmenin yolu çoğu zaman çit kapatmaktan değil, kapıları ardına kadar açık tutmaktan geçer.
- Karşı hamle: açık kaynak, açık veri ve müşterekler
3.1. PhotoCraft: Açık kaynak geri ısırıyor
Kuramsal zemini bir kenara bırakıp pratiğe, yani somut bir karşı hamleye inelim: PhotoCraft. Ekim 2026’da duyurulan habere göre dört kişilik bir ekip, Adobe’nin en çok kullanılan yedi aracını Claude 5.5 ile tersine mühendislikle çözerek yeniden üretmiş ve açık kaynak olarak yayınlamış; ArtCraft’ın kurucularından Michael Caffrey’e göre ortaya çıkan şey “bir alternatif değildi, daha iyiydi” [12].
Peki PhotoCraft’ı bu kadar önemli kılan ne? Her şeyden önce kendisi: tamamen Rust ile yazılmış, “açık kaynak, çevrimdışı ve senin” bir araç — seçim ve maskeleme araçları cihazın üzerinde çalışıyor, yani görüntüler “senin makinende, başkasının sunucusunda değil” işleniyor [13]. Adobe’ye yöneltilen eleştiri ise çok açık: yüksek abonelik ücretleri, iptal ücretleri, bulut bağlantısına zorlanan araçlar — yazılımı satın almak yerine “kiralamak” [12]. Onlarca yıldır yaratıcı emeğin neredeyse tek muhatabı olan bir şirketin tekelinden çıkış, kullanıcının elinde yazılımın kendisini tutmasıyla başlıyor.
Caffrey’in bu hamleyi özetlerken kullandığı “kozmik karma” ise aslında yazının tamamına yayılan bir tez: “Teknoloji endüstrisi on yıllardır açık kaynak topluluğunun sırtından geçindi; şimdi modeller açık kaynak kodla eğitiliyor. Açık kaynağın geri ısırması bir bakıma kozmik karmadan ibaret” [12]. Açık kaynağın görünmez emeği, kapalı devlerin girdisi hâline geldi; şimdi o girdi, kapalı devleri sarsacak alternatiflerin üretiminde kullanılıyor.
Ne var ki tam burada kaçınılmaz bir paradoks yükseliyor: ArtCraft’ı mümkün kılan modelin kendisi — Claude — istiflenmiş veriyle eğitildi. Sorunun aracı, çözümün aracı olabilir mi? Bu sorunun yanıtı, bizi açık kaynağın tek başına yetmediği noktaya, verinin kendisine taşıyor.
3.2. Dev şirketler niçin kullanıcıların boğazlarından içeriye YZ algoritmalarını zorlamakta?
PhotoCraft cephesi uygulamalarla, yani tek tek araçlarla savaşırken bu ikinci cephenin hedefi çok daha derinde: işletim sisteminin kendisi. Zira devler YZ’yi boğazımızdan içeriye zorlamak için işletim sisteminden daha stratejik bir kapı bulamazlar — bir uygulamayı kurmamak ya da silmek elimizde, ama işletim sistemi her şeyin üzerinde kurulduğu zemin, yani kapının ta kendisi. Microsoft’un Windows 11’e eklediği yapay zekâ bileşenlerinin — Copilot’tan Recall’a, kapatılamayan Ayarlar ajanına kadar — büyük bölümünün Home ve Pro sürümlerinde kalıcı olarak devre dışı bırakılamaması bu stratejinin dolaylı itirafı sayılmalı [14]. Apple ise Apple Intelligence’ı macOS’un merkezine öylesine işledi ki ortada tek bir “kapat” anahtarı kalmadı; tam denetim ancak kurumsal cihaz yönetimi (MDM) profilleriyle mümkün [15].
Peki bu ısrarcılık neden? Çünkü YZ, yazılımı satın almak yerine kiralamanın en kusursuz aracı: her ekran görüntüsü, her sesli sorgu, her işlenen belge, Zuboff’un ifadesiyle davranışsal artığın dökümü; üstelik kullanıcıyı ekolojisine kilitledikçe çıkış maliyeti de artıyor. Adobe’nin abonelik ve iptal ücretleriyle kurduğu düzen, işletim sistemi ölçeğinde Microsoft ve Apple’ın kurduğu düzenin minyatürü; fark yalnızca kapsamda.
Açık kaynağın bu cephedeki cevabı ise yazılımı çalmaya çalışan yazılımın ta kendisi: YZ silicileri. GitHub’da geliştirilen RemoveWindowsAI projesi, PowerShell betikleriyle Copilot’ı, Recall’ı, sesli erişimi ve Notepad, Paint, Photos, Edge içindeki YZ entegrasyonlarını sistemden söküyor; hem yedekleme hem geri dönüş modları sunuyor, hem de Windows güncellemelerinin silinen bileşenleri geri yüklemesini engelleyen temizlik adımları içeriyor [16]. Win-AI-Tools ise işi bir adım öteye taşıyıp on bir farklı YZ entegrasyonunu tek tek açıp kapatabilen grafik arayüzlü bir araç sunuyor [17]. Üstelik PhotoCraft’ın “senin makinende, başkasının sunucusunda değil” ilkesinin bir türevi olarak, makinenin artık istese bile YZ’siz bir makine olabilmesini mümkün kılıyorlar.
Bu silicilerin antivirüs yazılımları tarafından zararlı yazılım sayılması ise başlı başına bir ironi: denetimi sistemden alıp sahibine geri veren araç, denetim sistemlerinin gözünde suça dönüşüyor. Ne var ki burada söz konusu olan yalnızca kişiselleştirme özgürlüğü değil; işletim sistemini kullanıcı deneyimini hammaddeye dönüştüren bir aygıta çeviren aynı istifleme mantığının ta kendisi. Ve silicilerin bile geri alamayacağı bir şey var: sisteme şimdiden pompalanmış olan veri. İşte bu yüzden asıl savaş, PhotoCraft’tan Windows 11’e uzanan bu hat boyunca yazılımın ötesine, verinin kendisine taşıyor — 3.3’te ele alacağımız külliyat cephesine.
3.3. Kitaplar veri müştereki ve açık külliyatlar
Asıl cephe yazılımdan çok verinin kendisinde açılıyor; “kitaplar veri müştereki” (books data commons) önerisi tam da bu noktada devreye giriyor: milyonlarca kitabın dijitalleştirilmiş hâli, şirket tekeline değil, kütüphanelerin ve kamunun ortak yönetimine bırakılmalı [18], [19]. Altında yatan eşitlik argümanı ortada: milyonlarca kitabı dijitalleştiren şirketler, başkalarının erişemeyeceği bir avantaj kazanıyor; geriye kalan herkesin tek seçeneği o modellere abone olmak oluyor [19]. Oysa dijitalleştirmenin kendisi — tıpkı kütüphanelerin kurulması gibi — kamusal bir görev olarak yeniden sahiplenilmeli.
Burada durup “peki bu uygulanabilir mi?” diye sormak gerek; istifçilerin en güçlü bahanesi hep uygulanabilirlik olmuştur zira. Oysa Common Pile 0.1 ve Harvard’ın Institutional Books 1.0’ı, yalnızca kamu malı ve açık lisanslı kitaplarla eğitilen modellerin rekabetçi sonuçlar verebildiğini gösterdi [20]. Dahası Common Corpus, 30’dan fazla dilde, yaklaşık iki trilyon tokenlık bir külliyatı kamu malı ve açık lisanslı kaynaklardan bir araya getiriyor; çokdillilik, köken şeffaflığı ve denetlenebilirlik iddiasıyla — yani istifçinin opak tekellerine birebir zıt bir etikle — yola çıkıyor [21], [22].
Yine de açıklık kendi başına bir reçete değil; dürüstlük bunu kayıt altına almayı gerektirir. Widder ve arkadaşları, “açık” retoriğinin tek başına güç yoğunlaşmasını bozmadığını, büyük firmaların açıklığı kendi lehine araçsallaştırabildiğini gösteriyor [23]. Benzer bir sınır aktivasyon cephesinde duruyor: açık ağırlık (open weight) indirmek, kullanılabilir bir sistem değildir; veri ve hesap yoğunlaşması, açık modelleri de büyük oyunculara bağımlı kılar. Nitekim Tan ve arkadaşlarının formülü net: “açık kaynak kazanacaksa kamuya açılmalı” — yani açıklık, kamusal altyapıyla (public AI) desteklenmedikçe salt bir lisans meselesi olarak kalmaya mahkûmdur [24].
Tüm bu kavşakta üç ayaklı bir çerçeve yükseliyor: açık kaynak (kod ve model), açık veri (külliyat) ve kamu altyapısı (barındırma ve hizmet) [25], [26]. İstifçinin alabildiğine kapatmaya çalıştığı külliyata karşı ancak bu üçü bir arada, ortaklaşa ve denetlenebilir biçimde kurulursa anlamlı bir hat inşa edilebilir — ve bu hat, sorunun aracıyla çözümün aracı arasındaki paradoksu da kendi lehine çevirir.
- Sonuç: istifçilik mi, müşterek mi?
Bu yazı boyunca iki kutup arasında gidip geldik: bir yanda istifleme — özel, tekelci, opak girdi; diğer yanda müşterekler — açık, ortak yönetilen, denetlenebilir kaynak. Anthropic’in kitap operasyonu ilkinde duruyor; PhotoCraft, veri müştereki ve açık külliyatlar ikincisinde. Ama asıl mesele, bu iki kutuptan hangisinin kazanacağı değil; kazansak bile açıklığın ne anlama geleceği.
Dijital kamu egemenliği tek bir taahhütten doğmuyor; açık kaynak, açık veri ve kamu altyapısı birbirini tamamlamadıkça “açıklık” yalnızca pazarlama dili olarak kalıyor [23], [24]. Widder ve arkadaşlarının uyarısı burada hayati: büyük firmalar açıklığı kendi lehine araçsallaştırabilir; Tan ve arkadaşlarının formülü de bu uyarının ikizi: açık kaynak kazanacaksa kamuya açılmalı.
Basilisk’e dönersek: her şeye kadir model ancak külliyat toplam ve tekelci ise şantaj yapabilir; eserini herkesin erişebildiği açık bir müşterekte tutan hiç kimse tek bir şirketin kehanet motoruna rehin olamaz — müşterekler, istifçinin basiliske dönüşen modelinin panzehiridir [6]. Ancak panzehir, yalnızca modeli değil, onu besleyen külliyatı — kitapları, veriyi, belleği — istifleyicilerin elinden almayı da gerektirir. PhotoCraft’a dönüşte görebileceğimiz şey, açık kaynağın yazılımı kurtarmayı tek başına başaramadığıdır; onu besleyen külliyat aynı mantıkla kamulaştırılmadıkça, açık kaynak yalnızca istifçinin tarlasında açan bir çiçek olarak kalır.
Sonuçta soru şu: istifçilik mi, müşterek mi? Cevap, istifçinin külliyatının toplam ve tekelci olmaktan çıkarılıp, açık, ortak ve denetlenebilir bir müşterek hâline getirilmesiyle verilir. O zaman belki de yazının başında Arundhati Roy’un “terminate with extreme prejudice” çığlığına düşen öfkenin karşılığı, bir silah değil, bir bahçe olmalıdır — istifçinin çitle çevirdiği tarlanın kapılarını söküp hepimize açan bir bahçe.
[1] A. Roy, “Artificial intelligence and society.” https://www.equator.org/articles/arundhati-roy-artificial-intelligence, 2026.
[2] M. Tyson, “Nvidia accused of trying to cut a deal with Anna’s Archive for high-speed access to the massive pirated book haul — allegedly chased stolen data to fuel its LLMs.” https://www.tomshardware.com/tech-industry/artificial-intelligence/nvidia-accused-of-trying-to-cut-a-deal-with-annas-archive-for-high-speed-access-to-the-massive-pirated-book-haul-allegedly-chased-stolen-data-to-fuel-its-llms, 2026.
[3] Associated Press, “Anthropic to pay authors $1.5 billion in settlement over chatbot training material.” https://www.npr.org/2025/09/05/g-s1-87367/anthropic-authors-settlement-pirated-chatbot-training-material, 2025.
[4] F. Mancino, “Destroying books to build a mind.” https://www.newyorker.com/culture/the-lede/destroying-books-to-build-a-mind, 2026.
[5] K. James, “Why is anthropic destroying books?” https://www.theguardian.com/commentisfree/2026/aug/05/anthropic-ai-destroying-books, 2026.
[6] R. [kullanıcı adı], “Solutions to the altruist’s burden: The quantum billionaire trick.” https://www.lesswrong.com/w/rokos-basilisk, 2010.
[7] B. Singler, “Roko’s basilisk or pascal’s thinking: Thought experiments as implicit religion,” Implicit Religion, 2018.
[8] J. Boyle, “The second enclosure movement and the construction of the public domain,” Law and Contemporary Problems, vol. 66, no. 1–2, pp. 33–58, 2003.
[9] S. Zuboff, The age of surveillance capitalism: The fight for a human future at the new frontier of power. New York: PublicAffairs, 2019.
[10] Y. Benkler, The wealth of networks: How social production transforms markets and freedom. New Haven, CT: Yale University Press, 2006.
[11] C. Hess and E. Ostrom, Eds., Understanding knowledge as a commons: From theory to practice. Cambridge, MA: MIT Press, 2007.
[12] J. Wilkins, “Adobe in trouble after someone reverse engineered adobe creative suite and released it as open source.” https://futurism.com/future-society/adobe-creative-suite-software-open-source-artcraft, 2026.
[13] ArtCraft, “PhotoCraft: Açık kaynak görüntü düzenleyici.” https://getartcraft.com/apps/photocraft, 2026.
[14] I. Jenic, “Microsoft keeps adding AI to Windows 11, and most users can’t fully disable it.” https://www.neowin.net/reports/microsoft-keeps-adding-ai-to-windows-11-and-most-users-cant-fully-disable-it/, 2026.
[15] W. Gallagher and M. Wuerthele, “Companies aren’t being forced to stop buying macs because of Apple intelligence.” https://appleinsider.com/articles/26/10/08/companies-arent-being-forced-to-stop-buying-macs-because-of-apple-intelligence, 2026.
[16] zoicware [GitHub kullanıcısı], “RemoveWindowsAI.” https://github.com/zoicware/RemoveWindowsAI, 2026.
[17] waar19 [GitHub kullanıcısı], “Win-AI-tools.” https://github.com/waar19/win-ai-tools, 2026.
[18] Creative Commons, “Exploring a books data commons for AI training.” https://creativecommons.org/2024/04/08/exploring-a-books-data-commons-for-ai-training/, 2024.
[19] P. Keller, A. Tarkowski, B. Masiello, and D. Slater, “Towards a books data commons for AI training.” https://openfuture.eu/publication/towards-a-books-data-commons-for-ai-training/, 2024.
[20] A. Tarkowski, “Common pile and institutional books datasets chart two pathways for AI commons.” https://openfuture.eu/blog/common-pile-and-institutional-books-datasets-chart-two-pathways-for-ai-commons/, 2025.
[21] P.-C. Langlais et al., “Common corpus: The largest collection of ethical data for LLM pre-training.” https://arxiv.org/abs/2506.01732, 2025.
[22] Walled Culture, “Common corpus, an open training set for AI, goes global — and so should support for it.” https://walledculture.org/common-corpus-an-open-training-set-for-ai-goes-global-and-so-should-support-for-it/, 2026.
[23] D. G. Widder, M. Whittaker, and S. M. West, “Why ‘open’ AI systems are actually closed, and why this matters,” Nature, vol. 635, pp. 827–833, 2024, doi: 10.1038/s41586-024-08141-1.
[24] J. Tan et al., “If open source is to win, it must go public.” https://arxiv.org/abs/2507.09296, 2025.
[25] T. O’Reilly, “Why open source matters for AI.” https://www.oreilly.com/radar/why-open-source-matters-for-ai/, 2026.
[26] New America, “Openness in artificial intelligence models: Benefits of open-source AI.” https://www.newamerica.org/insights/openness-in-artificial-intelligence-models/benefits-of-open-source-ai/, 2026.